مسئله از کجا شروع میشود؟
یک سامانه احراز هویت چهره با آرایهای از پیکسلها روبهرو است، اما باید مفاهیمی مانند محل چهره، زاویه سر، کیفیت، هویت و احتمال حمله را از آن استخراج کند. روشهای جدید این کار را با زنجیرهای از مدلهای یادگیری عمیق انجام میدهند. شبکههای عصبی کانولوشنی یا CNN یکی از مهمترین خانوادههای مدل در این حوزهاند.
CNN چیست؟
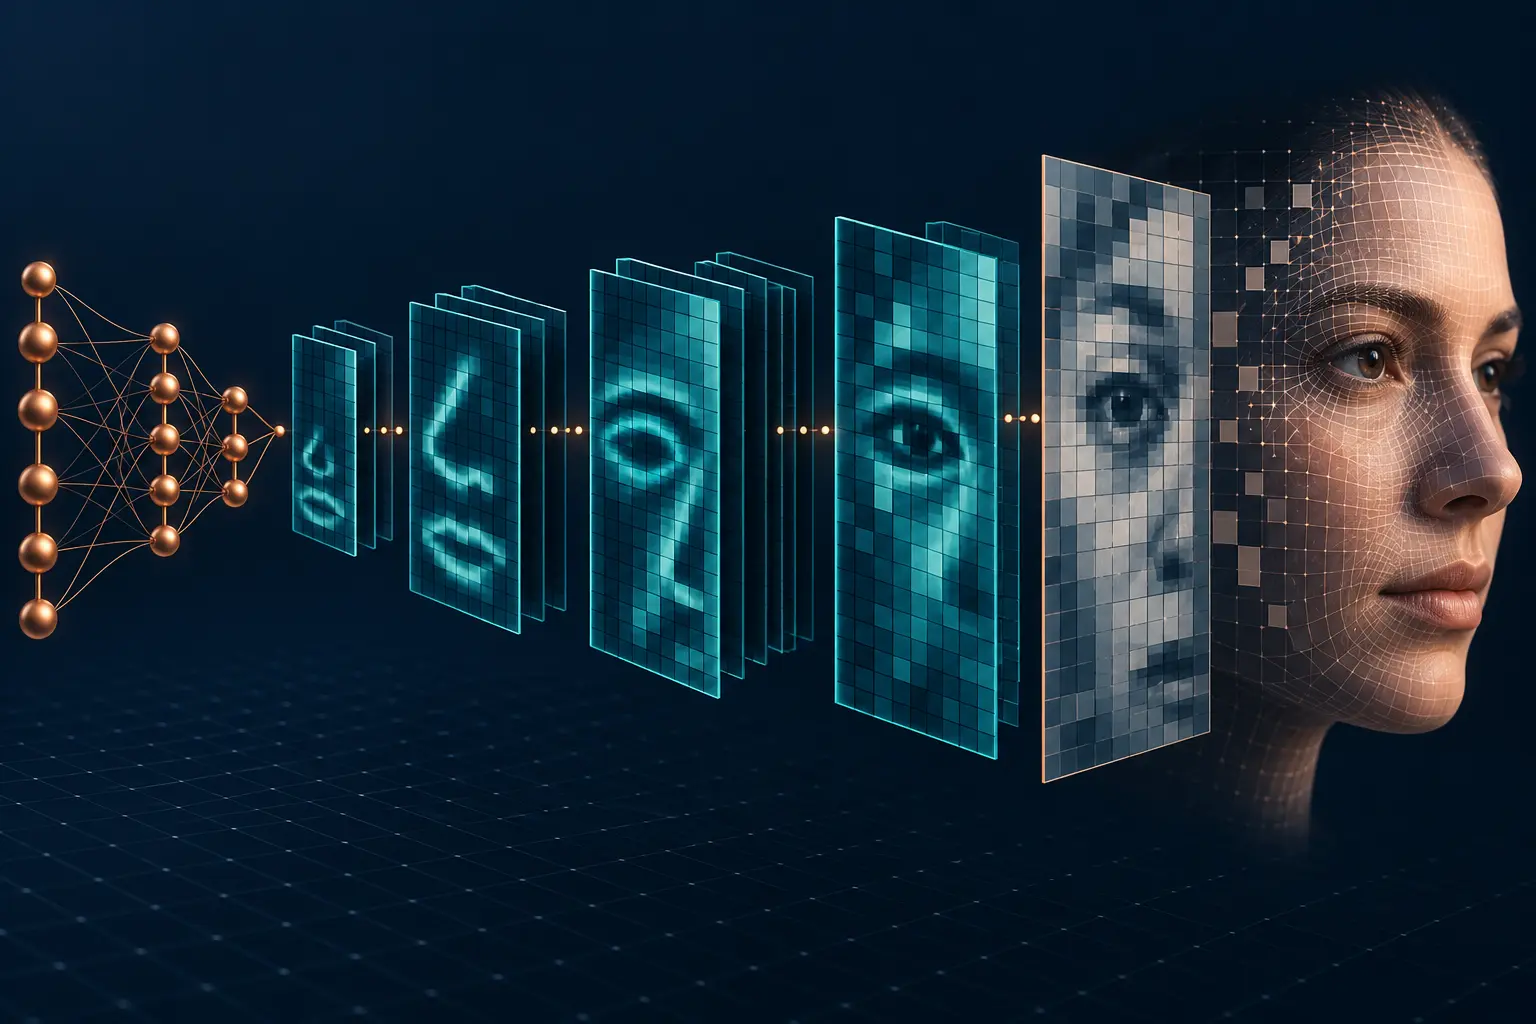
CNN نوعی شبکه عصبی است که برای تحلیل دادههای شبکهای مانند تصویر طراحی شده است. یک فیلتر کوچک روی نقاط مختلف تصویر حرکت میکند و الگوهای محلی را استخراج میکند. در لایههای ابتدایی، الگوهایی مانند لبه، جهت و تغییر روشنایی شناسایی میشوند. لایههای میانی ترکیبهای پیچیدهتری مانند چشم، بینی و بافت پوست را میآموزند و لایههای عمیقتر نمایش فشردهای از کل چهره میسازند.
سه مفهوم اصلی در CNN عبارتاند از:
- کانولوشن: اعمال فیلترهای آموختهشده در نقاط مختلف تصویر.
- تابع فعالسازی: افزودن رفتار غیرخطی تا شبکه بتواند الگوهای پیچیده را یاد بگیرد.
- کاهش ابعاد: خلاصهکردن اطلاعات و افزایش مقاومت در برابر تغییرات کوچک مکانی.
وزن فیلترها در زمان آموزش و با مشاهده نمونههای فراوان تنظیم میشوند. به همین دلیل کیفیت و تنوع داده آموزشی مستقیماً بر رفتار مدل در محیط واقعی اثر میگذارد.
زنجیره تشخیص و تطبیق چهره
۱. تشخیص چهره
مدل Detector محل چهره را در تصویر مشخص میکند و معمولاً نقاط کلیدی مانند چشمها، بینی و گوشههای دهان را نیز تخمین میزند. Confidence بالا به معنی اطمینان مدل از وجود چهره است؛ نه تأیید هویت فرد.
۲. همترازی
با استفاده از نقاط کلیدی، چهره چرخانده و به اندازه استاندارد تبدیل میشود. همترازی باعث میشود مدل Recognition روی موقعیت نسبتاً ثابتی از اجزای صورت کار کند و تفاوت زاویه یا کادر تأثیر کمتری داشته باشد.
۳. استخراج ویژگی
مدل Recognition تصویر همترازشده را به یک بردار عددی تبدیل میکند. این بردار باید تصاویر یک شخص را، با وجود تفاوت نور، سن یا دوربین، نزدیک به هم و تصاویر افراد متفاوت را دور از هم قرار دهد.
۴. محاسبه شباهت و تصمیم
شباهت دو بردار با معیاری مانند Cosine Similarity محاسبه میشود. Compare امتیاز را برمیگرداند؛ Verify همان امتیاز را با Threshold کالیبرهشده مقایسه میکند و تصمیم Match یا No Match میسازد.
CNN در تشخیص زندهبودن
تشخیص زندهبودن یا Presentation Attack Detection مسئلهای متفاوت از شناخت هویت است. مدل به دنبال نشانههایی میگردد که نمونه واقعی را از حمله جدا کنند:
- الگوهای چاپ، پیکسل و Moiré مربوط به نمایشگر؛
- بازتاب نور و تفاوت بافت میان پوست و کاغذ یا صفحه نمایش؛
- لبههای غیرطبیعی، اعوجاج و نشانههای بازپخش؛
- سازگاری مکانی اجزای صورت و زمینه؛
- تغییرات زمانی در چند فریم ویدئو.
مدل تکفریمی فقط یک تصویر را تحلیل میکند. مدل زمانی، توالی فریمها را میبیند و میتواند حرکت، تغییر نور یا الگوهای بازپخش را بهتر بررسی کند، اما هزینه پردازشی و حساسیت بیشتری به کیفیت ویدئو دارد.
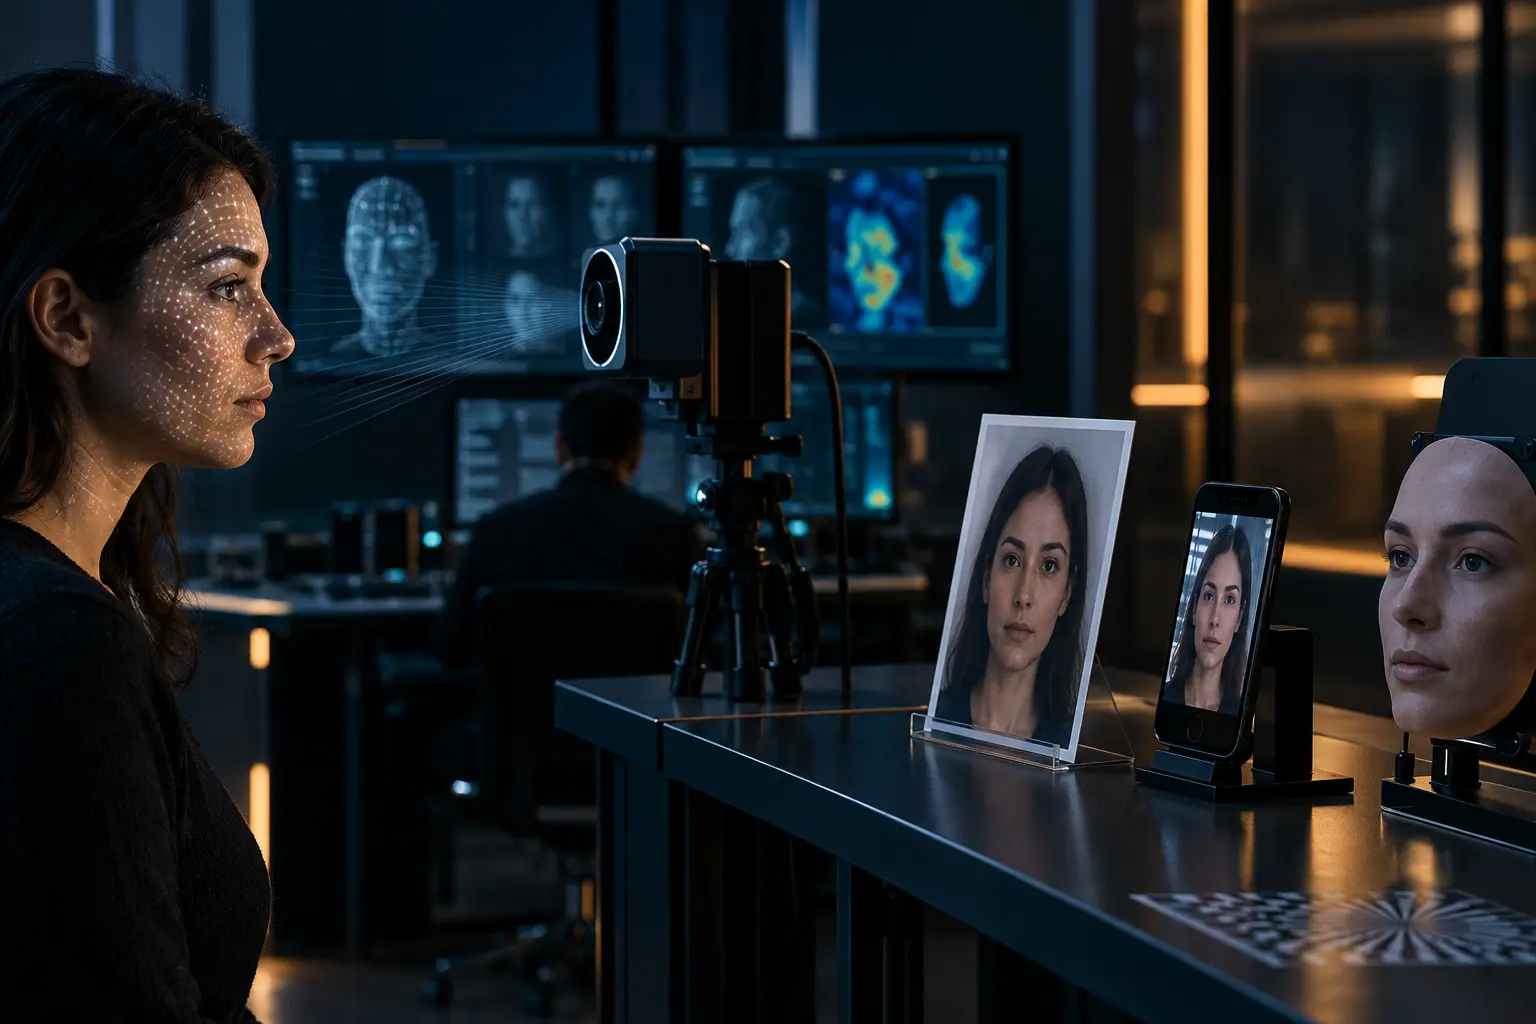
یک پروتکل آزمون مناسب باید حملات را به تفکیک ابزار ارائه، نوع نمایشگر، کیفیت چاپ، فاصله، زاویه و نور ثبت کند. گزارش یک میانگین کلی ممکن است ضعف مدل در برابر یک خانواده حمله را پنهان کند.
معماریهای جدیدتر از CNN کلاسیک
بسیاری از مدلهای عملی هنوز از CNN استفاده میکنند، اما معماریهایی مانند Vision Transformer و Swin Transformer نیز رایج شدهاند. این مدلها با سازوکار Attention رابطه میان نواحی دورتر تصویر را بهتر مدل میکنند. Swin تصویر را در پنجرههای محلی پردازش و با جابهجایی پنجرهها اطلاعات را میان نواحی منتقل میکند؛ بنابراین میان جزئیات محلی و درک ساختار کلی تعادل ایجاد میشود.
انتخاب معماری بهتنهایی موفقیت را تضمین نمیکند. داده آموزشی، پیشپردازش، اندازه ورودی، روش کالیبراسیون، نوع حملات و دامنه عملیاتی همگی تعیینکنندهاند.
چرا Generalization دشوار است؟
یک مدل ممکن است روی داده آزمایشگاهی نتیجه بسیار خوبی داشته باشد اما روی دوربین، نور، فشردهسازی یا نمایشگر جدید افت کند. این پدیده تغییر دامنه نام دارد. مدل بهجای مفهوم عمومی جعل، بخشی از ویژگیهای همان مجموعه آموزشی را یاد گرفته است.
برای کاهش این ریسک باید داده ارزیابی مستقل از آموزش باشد، سناریوهای واقعی سازمان را پوشش دهد و شامل دستگاهها و حملات دیدهنشده باشد. پایش پس از استقرار نیز ضروری است، زیرا الگوی ورودی و روش مهاجمان ثابت نمیماند.
شتابدهی و مقیاسپذیری
مدلهای عمیق میتوانند روی CPU اجرا شوند، اما GPU برای پردازش همزمان و شبکههای بزرگ مزیت قابل توجهی دارد. بهینهسازی فقط انتخاب سختافزار نیست؛ نمونهبرداری هوشمند ویدئو، Batch مناسب، جلوگیری از تبدیلهای اضافی تصویر، صفبندی و توزیع بار میان چند موتور نیز روی ظرفیت نهایی اثر میگذارند.
معیار درست، زمان یک Inference منفرد نیست. ظرفیت پایدار، تأخیر صدکی، رفتار زیر بار، مصرف حافظه و نرخ خطا باید در سناریوی نزدیک به Production اندازهگیری شوند.
جمعبندی
CNN و Transformer ابزارهایی برای استخراج الگو هستند. سامانه قابل اتکا زمانی ساخته میشود که تشخیص، کیفیت، Liveness، Recognition، کالیبراسیون و سیاست کسبوکار به شکل یک زنجیره قابل اندازهگیری طراحی شوند. هیچ مدل منفردی جای ارزیابی دادهمحور و کنترل چندلایه را نمیگیرد.
نمای مفهومی است؛ معماری واقعی میتواند CNN، Transformer یا ترکیبی از چند مدل باشد.